2014년 12월 31일 수요일

초보 개발자가 꼭 알아 두어야 할 다섯 가지 기술들

 오늘은 아무도 가르쳐 주지 않는, 그리고 이제 와서 누군가 에게 물어보기도 뻘쭘한 초보 개발자를 탈출하기 위해 필요한 테크닉에 대해 이야기 해 보고자 한다.

 초보 개발자가 고급 개발자가 되어가는 과정을 한마디로 정의하자면 "좀 더 게을러지기 위한 강렬하고 적극적인 의지의 표현"이 되겠다. "생산성"이니 "효율성", "정확성"같은 것 들은  프로그래머에게 있어서 부수적으로 얻어지는 것일 뿐 목적이 될 수 없다. 오로지 끊임없이 편하고 게을러지기 위한 노력만이 있을 뿐이다.


1. 마우스 안 쓰기

오늘날의 컴퓨팅 환경은 시간과 청각과 같은 인지 영역에 의거한 인간의 자연스러운 본능에 모든 행동이 정의되고 제약되는 게슈탈트 심리학의 세계이다. 그러니까 버튼은 누르고 싶게 생겨야 하고 이벤트 알람은 귀에 거슬리게 하여 주의를 끌 수 있어야 한다. 하지만 프로그래밍의 세계는 추상의 세계이다. 보이지 않는 본질을 파악하고 이를 다시 추상화 해 나가는 작업의 반복인 것이다.
 이러한 이유로 필자는 마우스(터치패드나 트랙패드를 포함) 안 쓰기를 초보 프로그래머에게 있어서 익혀야 할 기술의 첫번째로 이름을 올렸다.

 결론부터 말하자면 마우스는 프로그래머의 적이다. 마우스는 인체공학적인 면에 있어서도 손가락만 움직이면 되는 키보드와는 그 편의성과 정확성,속도면 에서 엄청나게 차이가 날 뿐만 아니라, 심리학에서 말해지는 몰입(flow) 상태를 방해 한다는 점에서도 프로그래머와는 궁합이 좋지 않다.

명필은 붓을 가리지 않는다고 하지만
손에 맞는 키보드 선택은 개발자에게 무척 이나 중요하다.
하지만 키보드 사는데 수 십 만원 썼다고 하면 사람들은 내가 음악가 인줄 알겠지?

 그럼에도 불구하고 마우스를 사용하게 되는 것은 순전히 직관에 끌리는 사람의 본능 때문 이다. 오늘날의 컴퓨팅 환경은 직관, 즉 시각과 청각을 최대한 활용하도록 설계되고 있다. 그러니까 마우스를 사용하지 않는 다는 것은 자연스러운 본능과의 싸움인 것이다. 하지만 걱정하지 말라, 결국 컴퓨팅 환경을 만들어내고 있는 것 들 또한 프로그래머 이며, 이들은 자신이 만든 프로그램에 키보드 사용자를 배려한 여러 장치를 해 놓는다. 단축키와 매크로 같은 것들 말이다.

 일단 오늘부터라도 작업에 주로 사용하는 어플리케이션의 주요 기능들을 반드시 단축키를 사용해서 진행하는 습관을 들여보자. IDE뿐만 아니라 워드나 오피스, 그리고 윈도우와 같은 OS 관련 단축키도 포함해서 말이다. 상급 개발자라고 하는것은 무언가 대단한 이치를 깨달은 사람이 아닌 별거 아닌 작은 습관들을 몸에 익힌 사람들일 뿐이다.


2. Command Line Interface

 상징적인 의미 이외에 현실적으로도 Command Line Interface(이하CLI)는 프로그래머가 보다 적극적이고 강렬하게 게을러지기 위해 꼭 필요한 중요한 도구이다. CLI는 동일한 작업의 반복 수행 뿐만 아니라 바로 위에서 언급한 마우스 사용의 억제에도 큰 도움이 된다.

대표적인 CLI화면인 Dos Prompt 


  CLI는 쉘 자체로도 다양한 작업이 가능하지만 AWK나 GREP와 같은 툴을 함께 사용한다면 엄청난 시너지 효과를 낼 수 있다는 사실도 잊지 말자. 윈도우의 경우 powershell을 사용한다면 DOS스타일의 bat보다 훨씬 다양한 작업이 가능하지만,  cygwin이나 unix utils를 이용한 유닉스 스타일의 쉘 작업을 익혀 둔다면,  윈도우 뿐만 아니라 유닉스, 리눅스는 물론이오 BSD를 기반으로 한 Mac OS에서도 요긴하게 써 먹을 수 있다.

 어찌 되었든, 하루에 두 번 이상 행하는 작업들은 무조건 CLI를 이용해 자동화 할 궁리를 하자!


3. 정규표현식

 부끄러운 이야기지만 필자 또한 정규 표현식을 제대로 다룰 수 있게 된 것은 비교적 최근의 일이다. 물론, 그 이전에도 정규표현식을 전혀 사용하지 않은 것은 아니지만 대부분 구글 검색에 의존해 완성된 식을 가져다가 파라메터를 바꿔서 쓰는 수준이었다. 변명을 하자면, 초보 개발자 시절 처음 접한 Perl 코드의 미칠듯한 정규표현식 해석 경험이 일종의 트라우마로 남아 있었던 듯 하다.

 이 정규표현식은 텍스트 데이터를 다루는데 있어서 엄청난 편의성을 제공한다. 특히 개발 도중 자주 직면하게 되는 복잡한 검색이나 치환 작업 들을 다루는데 있어서 대단히 편리한 도구이며, 게을러지기 위해서는 약간의 수고를 들여 꼭 익힐 필요가 있는 기술임에 의심의 여지가 없다.

 초보 개발자들에게는 다소 어려울 수 도 있지만 대부분의 이 바닥의 기술들이 그러하듯이 알고 나면 별거 아니다. 게다가 요즘에는 친절한 웹 튜토리얼들이 넘쳐난다!


4. 터미널 기반 텍스트 에디터

 이클립스나 IntelliJ, Sublime, Brackets와 같은 뛰어난 IDE가 넘처나는 시대이지만 아직까지 텍스트 편집기나 코딩 툴 로서 ViEditor(이하 Vim)이나 Emacs를 애용하는 개발자가 많이 있다. 텍스트 환경 위에서 움직이는 이러한 툴들은 위에서 언급한 키보드만 이용한 작업이라던지 터미널 상의 CLI인터페이스와 궁합이 좋기 때문이다.

 필자는 20년 가까이 vi를 사용해 오다가 얼마전에 Emacs로 넘어간 변절자 종 한 사람 이지만 양쪽 다 개발자에게 훌륭한 에디터 라고 생각한다. emacs를 사용한다 하더라도 vi는 대부분의 unix/bsd계열 os에서 기본 텍스트 에디터로 채용하고 있으므로 기초적인 사용법은 꼭 익혀 두도록 하자.


5. 구글 파워 서칭

 응? 이 양반이 초보라고 사람 무시하나? 아무리 초보 개발자라고 해도 구글 못 쓰겠냐고?
 아니다. 개발자에게는 개발자 다운 구글 사용법이 따로 있다.


 구글은 오늘날 프로그래머에게 있어서 문제 해결의 단서를 찾는 데에 절대 빼 놓을 수 없는 도구이지만 의외로 구글이 제공하는 강력한 검색 옵션 기능들을 제대로 사용하는 개발자는 많지 않다.

 속는 셈 치고 구글에서 제공하는 파워 Power Searching과 Advanced Power Searching 강의를 수강 해 보자. 아니 최소한 무슨 내용을 다루는지 만이라도 살펴보자. 단언컨데, 적은 노력으로 큰 편의를 제공할 것이다.


2014년 12월 30일 화요일

페어 프로그래밍을 넘어서 - Mob programming

 오늘은 최근 업무상 Ruby를 다루다 발견한 재미있는 프로그래밍 기법에 대해 소개해 보고자 한다.

 애자일 코치이자 개발 매니저인 우디 줄Woody Zuill이 제안한 Mob Programming이라고 하는 작업 기법은 페어 프로래밍의 확장판으로 우리말로 번역하자면 떼 코딩 정도가 되겠다.
우디 줄이 직접 그린 몹 프로그래밍 로고(?)
우선 몹 프로그래밍을 설명하기에 앞서 아이디어의 근원이 되는 페어 프로그래밍을 간단히 살펴보자. 


백지장도 맏들면 낫다 - 페어 프로그래밍

 페어 프로그래밍은 익스트림 프로그래밍에서 나온 에자일 개발의 대표적인 실천 방법 중 하나이다. 페어 프로그래밍에 대해 간단히 정리해 보자면 다음과 같다.

 페어 프로그래밍은 말 그대로 두 사람이 짝을 이루어 한 대의 컴퓨터로 작업한다. 키보드를 잡은 사람은 드라이버, 옆에서 이를 보조해 주는 사람은 네비게이터라고 부르며 각각의 역할은 다음과 같다.
페어 프로그래밍에서의 드라이버와 네비게이터는
명칭을 차용해 온 랠리 선수들의 역할 분담과 동일하다.
출전 : http://jesusgilhernandez.com/

  •  드라이버
 키보드를 조작하며 직접 코드를 작성한다.
 네비게이터와 논의가 가능 하도록 작성하는 모든 코드 요소들에 대해서 말로 설명해 가며 작업을 진행시킨다.
 네비게이터의 질문과 의견에 대해서 건설적으로 응답해야 하며, 네비게이터의 의견은 프로세스의 일부이므로 짜증을 내거나 방어적으로 대응해서는 안된다.
  •  네비게이터
 드라이버가 눈앞의 나무를 보며 달려간다고 한다면 네비게이터는 큰 지도를 살펴보며 목적지에 다다르는 길을 안내하는 역할을 해야 한다. 
 네비게이터는 드라이버의 작업을 지켜보며 더 나은 방법이 있다고 생각되는 부분에 대해서 조언하고, 의문이 드는 점에 대해서는 언제든지 질문 하며, 잘못되었다고 생각되는 부분에 대해서는 즉시 지적을 할 수 있어야 한다.

 페어 프로그래밍에 대해서는 한국 eXtreme Programming 사용자 모임에서 문서를 제공하고 있는데, 여러 경험자들의 노하우를 잘 정리해 놓고 있으므로 아직 읽어보지 않는 사람이라면 페어 프로그래밍에 대해서 어느 정도 알고 있다고 하더라도 시간을 들여 읽어 볼만한 가치가 있다.

 페어 프로그래밍 도입의 걸림돌로 주로 지적되는 것은 작업의 효율성이다. 당장 두 명의 프로그래머가 화면 하나로 작업을 해야 하니 아무래도 각자 작업하는 것 보다 작업 효율면에서 떨어지지 않겠느냐는 것 이다. 하지만 실제 도입한 경험자들의 경험담에 의하면 커뮤니케이션 비용 절감으로 작업 품질이 높아지는 것 이외에도 집중력의 지속도 크게 향상된다 한다. 
 필자는 실제 페어 프로그래밍을 체험해 보진 않았지만 당장 옆에 사람이 뻔히 지켜보고 있는데 웹서핑 같은건 할 수가 없을 것 같긴 하다. 아마도 여러 애자일 개발 실천 방법중 효과가 좋다고 보고되고 있음에도 불구하고 생각보다 널리 퍼지고 있지 않는 이유도 어쩌면 프라이버시 유지에 부담을 느껴서 이지 않을까? 

페어 프로그래밍만 하더라도 근무시간에 딴짓 하기가 불가능해진다.
2인용도 있쟎아?
출처: 안랩


 다구리에 장사 없다 - 몹 프로그래밍

 몹 프로그래밍은 한 명의 드라이버와 여러 명의 프로그래머가 하나의 PC로 코딩 또는 문서화 작업을 진행하는 개발 방식으로 1:1방식인 페어 프로그래밍을 1:n으로 확장시킨 형태이다. 여기서 n은 에자일 개발팀 전체 인원수로 팀 전원이 참여한다는 것이 특징이다.

몹 프로그래밍 풍경.
여러 명이 동시에 진행상황을 확인 할 수 있어야 하기 때문에
프로젝터를 사용하는 모습이 흔히 보여진다.
출처: mobprogramming.org


 백문이 불여일견이리라. 몹 프로그래밍이 어떠한 형태로 진행되는지는 다음 영상을 참고해보자. 영어도 필요 없고 딱 3분만 투자 하면 된다.

화면 맨 오른쪽의 머리 숱이 적으신 분이 우디 줄이다.

 몹 프로그래밍이 추구하는것은 페어 프로그래밍의 장점인 커뮤니케이션 비용 최소화를 통한 작업 효율을 극대화 이다. n명이 하나의 테스크에 동원된다는 것은 전통적인 작업 관리 측면에서 보면 엄청나게 비 효율적인 작업 방식이다. 당장 전통적인 관리자 입장이 되어보라. gantt chart에 사용할 선이 하나 뿐이다!

 하지만 몹 프로그래밍의 생산성에 대해 xper.org에서 페어 프로그래밍에 언급된 다음의 요소들을 고려해 보자. 몹 프로그래밍은 원래 페어 프로그래밍의 장점을 극대화 하려는 시도이므로 장점과 단점 역시 보다 극대화 된 형태로 드러나게 된다.

  • 통합시간 : 모든 작업들이 한개의 직선 위에서 진행되므로 개개인의 작업을 통합하는데 필요한 시간이 사라지게 된다. 특히, 각자의 머리속에 있는 지식 도메인의 통합이 작업과 동시에 이루어 짐으로서 커뮤니케이션 비용을 줄일 수 있을 것이다.
  • 코드라인수 : 일반적으로 페어 프로그래밍의 라인수는 혼자 작업한 경우에 비해 절반정도로 줄어드는 것으로 보고되고 있다. 이 결과는 매우 중요한 의미를 지니는데, 단순히 타이핑하는데 들어가는 시간의 절약 뿐만이 아니라 낮은 결함률 과도 연관이 있다. 어떤 언어든 라인당 결함수가 일정하다는 소프트웨어 공학적 사실을 놓고 볼 때에, 적은 양의 코드는 더 향상된 품질을 지니게 된다고 볼 수 있다.
  • 낮은 결함률 : 팀 전체가 함께 생각하며 코드를 작성하므로 당연히 결함률도 떨어지게 될 것이다. 특히,  커뮤니케이션 부족에서 오는 다양한 사양에 대한 결함도 그때그때 발견하고 해결이 가능하므로 완성되는 코드의 품질은 매우 높아질 것으로 기대되어진다.  
  • 집중 지속 시간 : 아무래도 모여서 같이 작업하면 딴 짓 하기 힘들어진다. 
  • 지식공유 : 잘 조직된 팀이라 할 지라도 개인간의 능력차는 엄연히 존재한다. 몹 프로그래밍에서는 자잘한 테크닉에서 부터 어플리케이션의 도메인 영역에 대한 이해까지 폭넓게 지식을 확산시키는데 매우 유용할 것으로 기대된다.  
  • 프로그래머 육성 패턴 : 위의 지식 공유의 연장 선상 에서 필자가 몹 프로그래밍을 주목하는 가장 큰 이유는 프로그래머 육성 패턴으로서의 가능성 때문이다. 이에 대해서는 잠시 후에 좀 더 자세히 언급해 보겠다. 

 프로그래머 육성 패턴으로서 몹 프로그래밍의 가능성

 앞에서도 언급한 바와 같이 원래 몹 프로그래밍은 페어 프로그래밍이 가진 커뮤니케이션 효율을 극대화 시켜 작업의 질을 높이기 위한 테크닉이지만 필자가 주목하는 부분은 지식과 경험의 전달 패턴, 즉 프로그래머 육성 방법으로서의 가능성이다.

 오픈소스가 일반화된 요즘 시대에서 가장 좋은 교재는 오픈소스 프로젝트이며 인터넷을 통한 정보공유가 일반화된 지금 시대에서 필요한 정보나 지식은 영어라는 장벽 하나만 넘는다면 얼마든지 얻을 수 있지만, 그럼에도 불구하고 보다 더 디테일한 고수들이 문제 해결 방법이나 사소한 습관들을 엿볼 수 있는 방법이 없을까 에 대해서 갈망하고 고민하게 된다.

  몹 프로그래밍은 지식과 노하우의 공유라는 측면에서 상당히 극단적인 형태를 띄게 된다. 드라이버 입장에서는 자신의 모든 작업 습관이 드러나게 되므로 부담이 적지 않겠지만 지식과 노하우의 공유라는 측면에서는 어께넘어 배우는 것 과는 비교도 할 수 없는 효율을 가져 올 수 있을 것이다.

 실제 몹 프로그래밍이 진행되는 모습을 참고해 보고 싶다면 Youtube등에서 mob programming이라는 키워드로 영상을 찾아 볼 수 있을것이다. 필자가 추천하는 영상은 애자일 소프트웨어 개발 운동의 발기인중 한명인 엘리스터 콕번이 루비를 이용해 진행하는 몹 프로그래밍 영상이다. 구글 행아웃을 이용해 원격으로 진행 되는 것이 한 장소에 모여 개발하는 일반적인 몹 프로그래밍과는 다르지만 몹 프로그래밍 방식으로 진행되는 개발의 흐름을 잘 엿볼 수 있다.  


emacs를 이용해 루비 코딩을 진행하는 방식 또한 눈여겨 봐 둘만 하다. 

몹 프로그래밍이 넘어야 할 벽 - 질문을 꺼려하는 문화

 몹 프로그래밍이 국내에 올바른 모습으로 보급되기 위해서는 무엇보다 넘어야 할 큰 장벽이 있다. 바로 질문을 꺼려하는 문화적 배경이다. 짝 프로그래밍 이든 몹 프로그래밍 이든 위계질서를 내려 놓고 열린 사고로 비판과 의문을 받아들이고 오답이든 정답이든 신경 쓰지 않고 솔직하게 자신의 생각을 밝힐 수 있어야 진정한 의미 에서의 의사 소통과 지식 공유가 이루어 질 수 있을 것이다.

질문이 허용되지 않는 경직된 문화 속 에서는
몹 프로그래밍이 아무리 좋은 기법이라 하여도
결코 올바로 자리 잡을 수 없을 것이다.

 뉴욕의 프로그래머 임백준은 ZDNet에 쓴 기사 -그대 힘으로 생각하라, 가차없이 질문하라- 를 통해 이처럼 질문을 꺼리는 문화가 인문학 결핍의 결과라고 말하고 있다. 필자 또한 이 의견에 격하게 동의하는바, ZDNet 기사의 일부분을 소개하며 Mob Programming소개 글을 마친다.

진정한 의미에서의 인문정신과 거리가 먼 우리의 교육과정과 직장문화는 사람들이 질문에 대해서 갖는 태도를 이렇게 기묘하게 우그러뜨려 놓았다. 질문을 구성하는 힘은 인문정신의 핵심이다. 질문을 하기도 잘 해야 하고, 받기도 잘 받아야 한다. 하지만 지금까지 우리는 인문정신이 탈색되어 사라진 무념무상의 순한 존재로 훈련되어 왔다. 
 질문을 받는다는 것은 (1) 자기 생각을 공개적으로 밝힐 수 있는 기회, 혹은 (2) 상대방의 질문을 내 생각대로 재구성할 수 있는 기회를 의미한다. 정답 혹은 오답이라는 개념은 없다. 그런데 우리는 질문을 받으면 정답을 말해야 한다는 심리적 압박 때문에 입을 열지 못한다.  오답을 말하는 것이 질문한 사람에 대한 무례라고까지 생각한다. 내가 스스로 무엇을 생각하는지가 아니라, 타인이 나를 어떻게 보는지가 더 중요하다.   


참고 문헌


2014년 12월 10일 수요일

자연어 처리의 고속실행을 위한 미들웨어 RaSC 소개

 형태소 분석이나 음성 인식 엔진과 같이 대용량의 사전 데이터나 메타 데이터를 이용하는 처리 들은 프로그램 기동시에 상당한 시간이 걸릴 뿐더러 처리 자체에도 시간이 많이 소요된다.

 오늘 소개하는 RaSC (Rapid Service Connector)는 이러한 무거운 처리 들을 고속으로 처리하기 위해 만들어진 병렬 실행 미들웨어로 독일의 Information Analysis Laboratory at the National Institute of Information and Communications Technology (NICT)에서 개발된 오픈소스 소프트웨어이다.

 아래의 내용은 일본어판영문판 RaSC소개 페이지의 내용을 정리한 것이다.

RaSC개요

 RaSC은 기존의 형태소 분석기 및 음성 분석기 등의 프로그램을 대량의 Web 페이지에 빠르게 적용하는 것을 염두에 두고 개발 되었다. 다양한 사용자 프로그램을 복수 인스턴스로 기동 시킨 후 서로를 연결하여 분산 병렬 처리를 실행 시키기 위한 미들웨어이다.

 처리의 예로는 하나의 파일이나 스트림에 있는 복수의 입력에 대해 사용자 프로그램을 멀티 인스턴스 기동시키고  멀티 코어 CPU를 활용하여 병렬 실행하거나 여러 머신상에서 분산 수행하는 것이 용이 하다. 또한 대용량 데이터를 분할하여 다른 컴퓨터에 저장하고 각각에 대응하는 다양한 어플리케이션을 여러 인스턴스에서 분할 된 데이터를 각각 처리하여 대규모 데이터의 고속 처리가 가능하게 된다.

RaSC는 자연 언어 처리를 염두에 두고 개발 되었지만, 지원하는 프로그램은 자연 언어 처리 프로그램에 한정되지 않고 다양한 프로그램에 적용 가능하다. 표준 입력이나 파일에서 입력을 받고 표준 출력 또는 파일에 결과를 출력하는 프로그램이라면 대부분의 경우 작은 변경 만으로도 RaSC에서 분산 수행 할 수 있다.

 RaSC에서 실행되는 어플리케이션 프로세스는 한 번 시작되면 컴퓨터에 상주한다. 따라서 사전 파일을 로드하는 언어 처리 프로그램처럼 거대한 파일의 로드 등으로 기동 시간이 길어지는 프로그램도 효율적으로 실행할 수 있다. 또한 웹어플리케이션과 같이 복수의 요청에 대해서도 처리 인스턴스를 복수의 기기/코어에 병렬 · 분산 실행하여 고속화 시킨다.

 다음은 구문 분석 시스템 KNP 을 RaSC에서 실행 한 예 이다.  500 라인의 문서 입력에 대해, 그것을 여러 실행 프로세스에 할당함으로써 멀티 코어 CPU에 의한 병렬 처리 (Intel Xeon X5675 * 2에서 8 병렬 실행)에서 5 배 정도의 처리 속도 개선이 이루어지고 있는 것을 볼 수 있다. 또한 원래의 입력 파일 (INPUT_TXT)의 입력 순서는 출력 파일 (OUTPUT_TXT)에도 저장된다.

$ time cat INPUT_TXT | juman | knp > OUTPUT_TXT  # Directly run a user program without RaSC
real    2m28.456s   # Without parallelization
user    2m17.557s
sys     0m1.011s
$ ./server.sh KNPService 19999 start # Start a RaSC service that runs KNP
$ time cat INPUT_TXT | java -cp ./lib/*: RaSCClient localhost 19999 > OUTPUT_TXT   # Other computer nodes can be accessed by changing the host and port.
real    0m29.402s   # Parallelization with RaSC (8 parallel processes on two Intel Xeon X5675)
user    0m0.566s
sys     0m0.045s

라이센스

 RaSC은 LGPL v2.1 로 배포되고 있기는 하지만 마이크로서비스 형태의 독립 웹 인터페이스로 다른 프로그램들과 연동 가능하므로 다른 LGPL오픈소스 DB와 마찬가지로 라이센스의 제약에서도 자유롭게 시스템 구성이 가능하다.

RaSC 서비스 화 가능한 프로그램 

RaSC 서비스화 하는 프로그램은 다음과 같은 조건을 충족해야 한다.


  • 표준 입출력을 통한 입출력 지원: 1 개의 입력이 주어지면 해당 결과를 출력하고 종료하지 않고 다음 입력을 기다린다.


  • 입력과 출력에 명시 적 종결 자 문자열을 출력: 형태소 분석 프로그램 MeCab 구문 분석 프로그램 J.DepP 등은 이러한 조건을 충족합니다. 개행을 종단하는 입력 1 개를 받으면 문자열 "EOS"를 종료 문자열로 결과를 출력한 후에 그 다음 입력을 기다린다.


이러한 조건을 충족하지 못하는 프로그램은 RaSC 서비스하려면 약간의 수정이 필요하다. 소스 코드가 있으면, 많은 경우 수정 그리 어려운 일이 아니라 SVM Perf , CRF ++ 등의 프로그램에 대해서는 RaSC사이트에서 RaSC 서비스에 대한 패치를 다운로드 할 수 있다.

현재 RaSC에서 작동이 확인된 프로그램들은 다음과 같다.
User programService definition XMLRemarks
Morphological analyzer MeCabService definition XML,
Service definition XML
(with 8-parallel processes)
Morphological analyzer JumanService definition XML,
Service definition XML
(with 8-parallel processes)
Dependency parser J.DepPService definition XML,
Service definition XML
(with 8-parallel processes)
A shell script is required to connect with MeCab through a pipe (refer to How to connect multiple user programs through a pipe)
Dependency parser KNPService definition XML,
Service definition XML
(with 8-parallel processes)
A shell script is required to connect with Juman through a pipe (refer to How to connect multiple user programs through a pipe)
Dependency parser EnjuService definition XML,
Service definition XML
(with 8-parallel processes)
GENIA taggerService definition XML,
Service definition XML
(with 8-parallel processes)
Speech recognition engine Julius-Refer to the article by Yuki Igarashi, at Tohoku University (in Japanese).
SVM PerfService definition XMLApply a patch to the SVM Perf (refer to Use SVM Perf)
CRF++Service definition XMLApply patch to the CRF++ (refer to Use CRF++)
TinySVMService definition XMLApply a patch to the TinySVM (refer to Use TinySVM)

Links


2014년 11월 19일 수요일

자연어 기계학습의 혁명적 진화 - Word2Vec에 대하여

 기계학습의 여러 분야중에서도 자연언어 처리는 가장 흥미진진하고 응용분야가 넓다. 하지만 이 분야의 연구 진행은 토론토 대학의 교수이자 구글에서 인공지능을 연구하고 있는 인공지능 분야의 거장인 Geoff Hinton이 reddit에서 진행된 질의답변 이벤트에서 지적한 바와 같이 반세기 가까이 벨 연구에서 진행된 연구들의 재탕에 지나지 않는 답보 상태에 있는 실정이다.
 여기에 최근 주목할만한 한가지 흐름이 나타났기에 이번 포스팅에서 소개해 보고자 한다.

출처 deeplearning4j

Word2Vec


 Word2Vec는 구글의 연구원인 Tomas Mikolov와 Kai Chen, Greg Corrado, Jeffrey Dean에 의해 쓰여진 논문인 "Efficient Estimation of Word Representations in
Vector Space(백터공간상에서 단어 의미의 효율적인 추정)"에서 제안된 방법을 구현한 알고리즘으로 기존의 알고리즘에 비해 자연언어 처리 분야에서 비약적인 정밀도 향상을 가능하게 하고 있다.

그렇다. 논문 저자의 한 명은 바로 그 Jeff Dean이다.

 Word2Vedc는 이름이 나타내는 바와 같이 단어의 의미를 벡터형태로 표현하는 계량기법으로,  각 단어를 200차원 정도의 공간에서 벡터로 표현하고 있다. 단어에 대한 벡터 표현 생성 연구는 이전에도 있었지만, 그들과의 차이는 그 벡터가 단순한 수학적 존재 이상의 복잡한 개념 표현을 넘어 추론까지도 손쉽게 구현이  가능하다는 점 이다.

Word2Vec를 나타낸 그림.
두 단어간의 거리는 관계성을. 방향은 문맥상의 의미를 내포하게 된다.
출처: insightdatascience.com


 Word2Vec의 가능성을 실감할 수 있는 예를 한가지 살펴보자.

Insight Data Science의 데이터 과학자인 Christopher Moody는 Word2Vec를 이용해 검색엔진 형태의 질의 응답 사이트를 만들었다.


 (이 글을 포스팅하는 시점인 2014년11월19일에는 접속이 안 되고 있음)

France - Paris + Seoul  = Korea

 위의 수식에서 프랑스France는 파리Paris와 연결되어  문맥 상 그 도시를 수도로 하는 국가를 나타내고 여기에 서울Seoul이 더해짐으로서 대한민국Korea이라는 결론이 도출된다.

 비슷하게 "왕 - 남자 + 여자 = 여왕"이라는 계산이나 "농구 - 마이클 조던 + 골프 = 타이거 우즈"와 같은 추론도 가능하다. 즉, 두 단어를 이은 방향이 문맥적 의미를 표현하게 되며  Word2Vec는 이러한 과정을 간단하게 처리하면서도 높은 정확도를 자랑한다.

 재미있는 예를 좀 더 살펴보자.

메트릭스의 생각없는 버전 = 블레이드2


이쯤되면 한국어 학습도 시켜보고 싶어진다.
넣어 보고 싶은 이름들이 많다.


 이와 같이, 문맥상의 의미를 정량화된 벡터로서 표현하는 것이 가능해지게 되는 것이다.
 논문이 발표되고 불과 1년 사이에 Tomas Mikolov 본인을 포함해 많은 연구자들이 어마어마한 양의 관련 논문들을 쏟아내고 있으며  딥 러닝을 통한 추론의 정밀도를 비약적으로 향상시킬 수 있다는 사실도 입증이 되었다.

Word2Vec는 어떻게 동작하는가?


 Word2Vec는 원래 인공 신경망 연구에서 태어났으며 같은 맥락을 지닌 단어는 가까운 의미를 지니고 있다는 전제에서 출발한다. Word2Vec는 텍스트 문서를 통해 학습을 진행하며 한 단어에 대해 근처(전후 5-10단어 정도)에 출현하는 다른 단어들을 관련 단어로서 인공 신경망에 학습 시킨다. 연관된 의미의 단어들은 문서상에서 가까운 곳에 출현할 가능성이 높기 때문에 학습을 반복해 나가는 과정에서 두 단어는 점차 가까운 벡터를 지니게 되는 것이다.

 원래 이러한 문제는 엄청난 계산을 필요로 하지만, Mikolov는 논문에서 계산 효율도 크게 향상 시켰고(논문의 저자 중 한 사람은 구글 최적화의 신으로 불리는 바로 그 Jeff Dean이다!), 그 결과 현재 C, Python, Java, Go, Scala등 다양한 언어로 구현이 진행되고 있다. 뿐만 아니라 Apache Spark등의 빅데이터 처리엔진도 이미 Word2Vec을 지원하고 있다.

Apache Spark MLlib Word2Vec 문서

물론 학습에 사용되는 문서의 양에 따라 학습에는 다소 시간이 필요하지만 텍스트 문장을 읽어 들이는 것 만으로도 동작 시키는 것 이 가능하기 때문에 매우 기초적인 프로그래밍 기술만 있으면 누구나 쉽게 사용이 가능하다.

 Word2Vec의 덕분에 자연어 기계학습 분야가 개발자들 사이에서 빠른 속도로 일반화 되어가고 있으며 연구자들로 부터도 막대한 논문들과 관련 오픈소스 라이브러리들이 쏟아져 나오고 있다. 그런데 정작 아이러니한 것은 Word2Vec의 계산 결과들이 어떻게 문맥적 의미들을 내포하게 되었는지 제대로 설명이 되지 않고 있다는 점 이다. 

무궁무진한 활용도

  Word2Vec는 간단한 사용법에 비해 터무니 없는 정확도를 제공함으로서 무궁무진한 활용이 기대되고 있다. 현재 많은 연구자들이 단어중심에서 문장이나, 영상, 이미지간의 백터 처리법으로 영역을 점차 확대시켜 나가고 있으며 이를 통해 분석결과의 정확도를 비약적으로 향상시켜 나갈 수 있을것으로 기대되고 있다.
 특히 문맥에 의한 의미파악이라는 특성은 지금까지도 상당한 난제로 손꼽히는 언어간 번역의 정확도를 높이는데 크게 기여할 수 있을것으로 예상된다. 

 모쪼록 이 글을 통해 보다 많은 개발자 들이 흥미를 가지고 한국어에 대한 의미있는 연구 결과들이 나오길 기대해 본다.

최신정보

Word2Vec 개발에 주도적인 역할을 담당한 Mikolov는 지난 8월 구글을 퇴사하고 페이스북으로 이적한 것으로 추정되며, 벡터 해석을 단어에서 구문까지 확장시킨 Paragraph2Vec의 구현에 주력하고 있다고 한다. Paragraph2Vec에 대한 논문은 현재 스텐포드 대학을 통해 공개되어 있으며 아래 URL에서 열람이 가능하다.


참고문헌


2014년 10월 13일 월요일

MapReduce를 대체할 구글의 새로운 빅데이터 분석서비스 - Google Cloud Dataflow

이번 포스팅에서는 발표된지 시간이 조금 지나긴 했지만 국내에는 아직 제대로 소개가 안된 Google Cloud Dataflow(이하 GCD)에 대해서 살펴보는 시간을 가져보고자 한다. GCD는 지난 6월 25일 열렸던 연례 개발자회의 'Google I/O 2014'에서 처음 공개가 된 구글의 새로운 빅데이터 분석서비스이다.

GCD는 이름에서 알 수 있듯이 구글의 클라우드 플래폼과 연동되어 사용 가능한 빅데이터 분석 서비스로,  "배치 모드"와 "스트리밍 모드"의 두가지 형태로 대량의 데이터를 처리 할 수 있다. GCP는 MapReduce의 후계로서 구글이 자사 서비스를 위해 독자적으로 개발한 병렬 처리용 잡바 프레임워크인 FlumeJava와 고속 데이터 프로세싱 어플리케이션 구축용 프레임워크인 MillWheel을 기반으로 개발되었다.

이제 GCD가 어떠한 것인지 구체적으로 살펴보자.
이하 사진들은 모두 Youtube에 공개된 키노트 세션 동영상에서 발췌하였다.

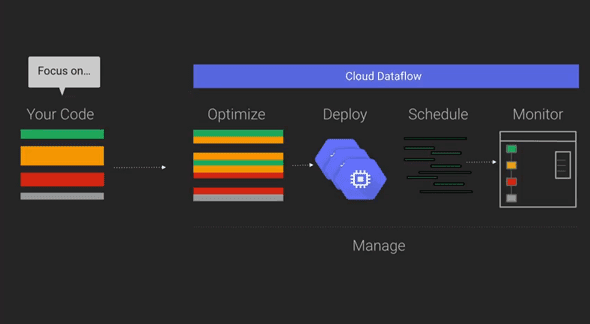
GCD의 기본적인 컨셉은 빅데이터를 다루는데 있어서 최적화, 배포, 스케줄링, 모니터링과 같은 주변 기능들을 모두 GCD가 담당해 주어 사용자는 빅데이터 분석 어플리케이션에 집중 할 수 있게 한다는 것 이다.

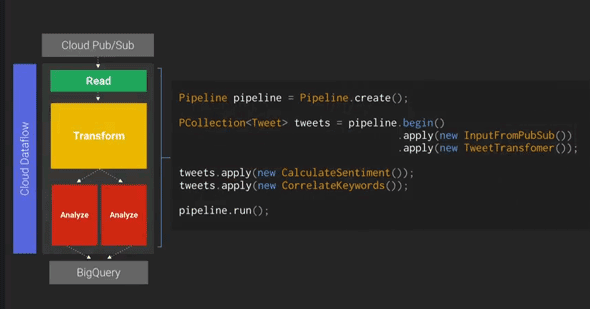
데이터 추출을 위한 코드의 예제. 트위터에서 실시간으로 발생하는 데이터를 파이프라인으로 연결하고 있는데, 현 시점에서 공개된 샘플은 자바 뿐이다.

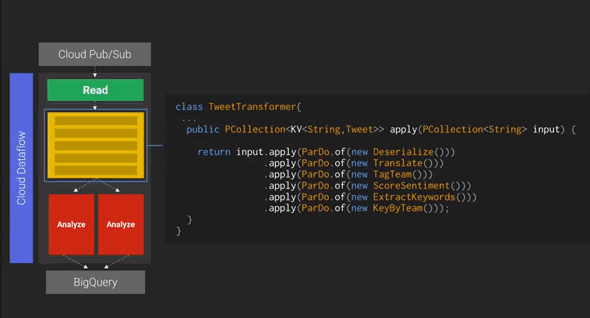
읽어들인 원시데이터를 변환하는 코드.

파이프라인을 사용하여 JSON형식의 데이터 스트림을 생성하여 일괄 처리할 데이터를 축척한 후에 다양한 형식으로 변환하고 있다. 

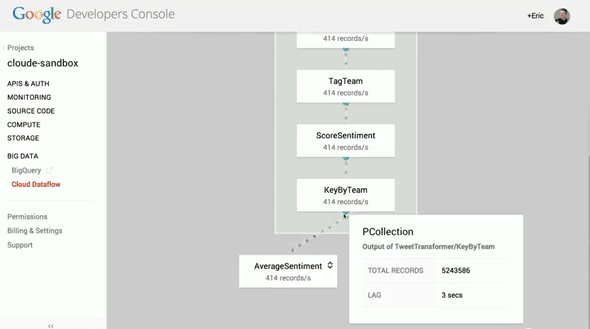
GCD는 처리 과정에 대한 실시간 모니터링 툴을 제공하고 있다.

GCD는 웹 콘솔로 클라우드 플랫폼 위에서 동작하는 자바 코드를 디버깅 할 수 있는 툴을 제공하고 있다. 이 툴은 프로덕션 환경에 영향을 주지 않으면서도 디버깅이 가능하다.
  GCD는 현재 상용서비스중인 BigQuery가 적은 학습비용에도 막강한 성능을 제공하는 빅데이터 분석 프로토 타이핑에 특화되어 있다고 한다면, 이에 비해 보다 다양하고 강력한 프로덕션 환경을 제공해 줄 것으로 기대된다.


2014년 10월 8일 수요일

마이크로서비스가 가져올 미래의 개발 패러다임

마이크로서비스에 대한 열풍이 대단하다. 작년 말부터 조금씩 들려오기 시작한 이 단어는 작년 부터 각종 개발자 행사에서 단골 소재로 등장하기 시작하더니 급기야는 올해 QCon San Francisco에서는 마이크로서비스 관련 카테고리를 만들기에 이르렀고, 아예 이틀짜리 마이크로서비스 컨퍼런스도 열리고 있는 형국이다. 도데체 왜 이렇게 사람들은 마이크로서비스에 열광하는가? 이제부터 실체에 접근해 보도록 하자.

마이크로서비스의 정의

늘 그렇듯이 무언가에 대해서 이야기 하기 위해서는 먼저 정확한 정의가 필요하다. ThoughtWorksJames LewisMartin FowlerMircoservices라는 기사에서 다음과 같이 정의하고 있다.

마이크로 서비스는 서비스 디자인스타일로서 작은 서비스의 결합을 통해 하나의 응용프로그램을 개발하는 방법으로, 각각의 서비스는 독립적인 비즈니스 로직으로 구성되며, 완전 자동화된 개발/배포환경에 의해 각각 독립적으로 배포될 수 있습니다. 최소한의 중심적인 관리 체계가 있으며, 이 시스템은 각각 다른 프로그래밍 언어, 다른 데이터스토리지 기술로 작성하는것이 가능합니다.

밥아저씨Robert C. Martin 또한 트위터에 다음의 짧은 글로 마이크로서비스에 대한 정의를 내리고 있다.

단일체Monolithic 대 마이크로서비스의 이분법은 잘못된 것입니다. 그것(마이크로서비스)은 단독으로 실행 가능하며 독립적으로 배포 가능한 특징을 지닙니다. 

어디서 많이 들어본 이야기 아닌가? 그렇다. 불과 2,3 년 전 까지만해도 가장 핫한 기술 트렌드 였던 SOA(Service Oritented Architecture)를 떠올리며 기시감Déjà Vu을 느끼는것은 당신만이 아닐것이다. 이 이야기는 잠시후에 자세히 다뤄 보기로 하고 우선은 마이크로서비스의 특징을 좀 더 살펴보도록 하자

왜 마이크로서비스인가?

 많은 개발자들은 마이크로서비스 인기의 가장 큰 이유로 시스템 규모와 복잡성에 대한 관리를 꼽는다. 마이크로서비스는 서비스를 충분히 작은 크기로 나누어 개발하되 상호 연계를 통해 좀 더 복잡하고 거대한 시스템을 만들어 갈 수 있다. 그리고 그러한 서비스들은 서비스의 양과 복잡성 뿐만이 아니라 스케일링에도 높은 자유도를 지니게 되는데 이러한 특징들은 오늘날 널리 확산되고 있는 클라우드 컴퓨팅이나 고확장성 시스템의 요구조건에 정확히 부합하고 있다.

잘 알려진 마이크로서비스의 특징과 장점은 다음과 같다.

  • 각각의 마이크로서비스는 심플하며, 각각의 비즈니스 요구사항에 특화되어 있다 - 개발자가 관리하는 스코프가 명확해지게되며, 이를 토대로 소프트웨어의 복잡성을 제어하는것이 가능해진다. 최근의 마이크로서비스들이 지향하는 방향은 UI와 컨트롤, 도메인로직이 별도의 마이크로서비스로 구성되어 완전히 독립적으로 개발이 가능한 방향으로 나아가고 있다는 점 이다. 즉, 웹프론트 개발자들은 서버사이드 처리를 몰라도 아무런 문제가 되질 않는다는 점 이다.
  • 각각의 마이크로서비스는 개별 팀에서 독립적으로 개발/배포가 가능하다 - 개발팀의 운영과 스케줄링에 있어서 높은 자유도를 가져다준다. 또한, 시스템의 규모가 커짐에 따라 추가로 발생하게 되는 오버헤드가 일정수준으로 관리가 가능해진다는 점도 빼 놓을 수 없는 마이크로서비스의 장점이다.
  • 각각의 마이크로서비스는 다른 프로그래밍언어, 다른 도구를 사용하여 개발 할 수 있다 - 요구사항을 구현하기위해 최적화된 언어와 아키텍처의 선택이 가능해진다.
  • 각각의 마이크로서비스는 다른 데이터 저장소를 사용할 수 있으며 서로 느슨하게 연결된다. - 언어선택과 마찬가지로 요구사항에 최적화된 DB의 선택이 가능해지며 각각의 마이크로서비스들은 서로간의 인터페이스에만 집중할 수 있게된다.
  • 고속 개발에 최적화 되어 있다 - DevOps와 결합된 각각의 마이크로서비스는 심플한 구조를 지니는 만큼 개발속도와 개선에 있어서 높은 효용성을 지닌다. 자동화된 유닛 테스트와 시나리오테스트는 빠른 배포주기에도 불구하고 뛰어난 품질을 유지할 수 있게끔 도와준다.
빠르고 지속적인 업그레이드는 치열한 IT비즈니스 경쟁에 있어서 가장 강력한 무기가 된다.
"Upgrade in progress"
출처 : Doctor Who


SOA와 마이크로서비스

 결론부터 이야기 하자면 SOA와 마이크로서비스는 동일한 발상이다.
그렇다면 왜 SOA가 아닌 마이크로서비스라는 새로운 용어를 꺼내들고 있는가? 필자의 생각으로는 여러 프로젝트에서의 실패로 SOA라는 용어 자체에 부정적인 이미지가 많이 입혀지게 된 것이 큰 이유가 아닐까 추측해 본다. SOA는 본래의 사상을 살릴 발상이나 구현이 제대로 확립되기도 전에 마케팅적 미사여구에 매몰되어 무엇이든 가져다 붙일 수 있는 마법의 기술로 변화되어 버렸다. 그리고 여러분들도 잘 알다시피 무엇이든 할 수 있다는 말은 아무것도 할 수 없다는 말과 동일하다.

2000년대 중반 시스템 개발의 현신적인 패러다임으로 각광받던 SOA는
2009년경에 이미 부정적인 이미지가 표면화되기 시작했다.
출처 : SOA is Dead; Long Live Services

 대표적인 실책중에 하나는 SOA가 서비스 독립적이라는 말을 하면서도 기존의 단일체 시스템에서 철칙처럼 여겨졌던 중앙집중식 데이터 관리 방식을 어떻게든 이어가려 하고 있었다는 점 이다. 흔히 ACID으로 대표되는 트렌젝션 신뢰성에 대한 원칙들은  SOA에서도 아무런 의심 없이 지켜져야 할 요소로 여겨지고  있었다. 이러한 데이터의 무결성을 유지하기 위해서 two-phase commit과 같은 분산 트랜젝션이 등장하게 되었는데, 분산 트랜젝션은 시스템 규모가 커지면 커질수록 성능에 치명적인 저하를 가져온다.

 단일체 시스템이 가질 수 밖에 없는 근본적인 제약을 그대로 지닌채  발상의 전환 없이 세상에 등장한 SOA는 출생부터 험난한 앞길이 예고되어 있었는데, 결국 장미빛 희망만으로 SOA를 채택했던 (정확히는 비싼돈을 들여서 ESB를 도입했던)많은 프로젝트들이 애초부터 고려되지 않은 다른 서비스들과의 연동에서 오는 오버헤드와  단일 트랜젝션 처리에 대한 롤백과 같은 이루어 질 수 없는 ACID준수에 대한 요구사항을 만족시키려고 발버둥치다 좌초되거나 본래의 목표를 잃어버린채 표류하는 운명을 맞이한다.

ESB와 API Gateway : SOA와 마이크로서비스처럼 사실상 동일한 개념이라고 봐야 한다. 간단한 스크립트 만으로 서비스들을 엮어 새로운 서비스들을 구성할 수 있게 해 준다는 개념은 얼핏 듣기에 매력적으로 들리지만 실제 문제영역에서 제대로 그 역할을 제대로 구현하는데에는 섬세한 모델링을 통한 접근이 필요하다. 이러한 집합체에 대한 문제는 도메인 주도 설계(이하 DDD)에서도 비중있게 다루고 있으므로 일독을 권한다.

마이크로서비스의 구현요소들

이러한 마이크로서비스를 구현하기 위해서는 어떠한 기술적 요소들이 필요할까? 마이크로서비스 구현을 위한 핵심요소들은 다음과 같다.

  • 데이터 분산 관리 : 분산트랜젝션을 말하는것이 아니다.  중앙집중형 데이터 관리 방식에 대칭되는 의미로서 이 용어를 사용하며 종래의 한가지 DB에 데이터를 집중시키는 방식에서 벗어나 필요에 따라 다양한 DB를 사용하는 이른바 Polyglot Persistense도 마이크로 서비스에서는 보다 쉽게 도입이 가능해 진다.


마이크로 서비스의 퍼시스턴스 구성 예
출처 : martinfowler.com
.


  • RESTful / AscyncProcess : 느슨한 결합과 처리의 비동기화를 위해 가장 효과적인 인터페이스이다. 비동기처리는 대규모 웹 서비스를 위해서는 필수 불가결한 존재이며 기존의 DB를 중심으로 이뤄지던 트랜젝션과는 다른 접근 방식 가져야 한다. 
출처: 4 Developing Asynchronous Web Services
  • 폴리그랏 아키텍쳐 : 임백준님의 폴리글랏 프로그래밍이나 마틴파울러의 Polyglot Parsistense로 대변되는 이른바 멀티 랭귀지, 멀티 파시스턴스를 이용한 개발 스타일이다. 각각의 서비스 목적에 맞추어 효율적인 언어와 플랫폼을 선택 할 수 있다는 장점이 있지만 한편으로는 언어나 프레임워크별로 발생하는 코드의 중복이라던지 관리해야 하는 기술의 스코프가 늘어난다는 문제가 있다. 이 점에 대해서는 잠시후에 좀 더 자세히 살펴보도록 하겠다.
  • DevOps : 대다수의 마이크로서비스 관련 문서에서 필수로 꼽는것이 바로 이 DevOps이다. DevOps는 CI에서 좀더 진화된 형태로,  개발, 테스트, 배포를 모두 자동화 시켜 개발 사이클이 끊임없이 순환되도록 함으로서 개발의 속도를 최대화 시키는 개발스타일 이다. 마이크로서비스의 경우 배포가 서비스의 수 만큼 이루어지게 될 뿐만 아니라 테스트 또한 각각의 서비스가 연동되어 발생하는 집합체Aggregate의 수 만큼 필요하게 된다. 이를 일일이 사람의 손으로 제어하는것은 엄청난 비용이 소요되며 이러한 문제점을 해소하기 위해 필연적으로 요구되는것이 바로 DevOps이다.
  • 클라우드 컴퓨팅: 독립된 배포라던지 각각의 서비스별로 관리 가능한 확장성부분에 있어서 마이크로서비스는 클라우드 컴퓨팅과 궁합이 잘 맞는다. 특히 Docker로 대표되는 컨테이너 방식의 개발은 DevOps와 어우러져 빠른 개발과 서비스 안정성, 유연한 확장성 이라는 세마리 토끼를 잡는데 최적의 솔루션으로 각광받고 있다.
  • 실패를 염두에 둔 설계Design for failure : 앞에서도 열거한 비동기 처리와 데이터의 분산관리는 필연적으로 한가지 처리가 단일 트랜젝션에 묶일 수 없다는 전제를 가져온다. 즉, 여러 마이크로서비스를 이용한 어떠한 복합기능이 도중에 실패하였을경우 이를 단일체시스템처럼 간단히 롤백하기가 쉽지 않다. 게다가 물리적으로도 여러개의 서버 인스턴스가 운영되게 되므로 시스템 전체로 보았을때 개별 마이크로서비스 인스턴스가 처리에 실패하더라도 전체 서비스가 문제 없이 움직일 수 있도록 가용성을 높이기위한 고려가 필수적으로 이루어져야 한다.

마이크로서비스의 문제점과 그 해결책 - 도메인 주도 설계

위에 열거한 바와 같이 많은 장점들을 지닌 마이크로서비스이지만 세상에는 공짜가 없는 만큼 치뤄야 할 대가가 있다. 기술적으로도 새로운 요소들의 도입이 검토되어야 하지만 서비스에 대한 관점이나 개발 사이클의 관리라던지 팀 구성과 같은 개발 전반에 걸친 발상의 전환이 필요하다.

Eric Evans가 저술한 도메인 주소 설계(이대엽역, 이하 DDD)에서는 이러한 마이크로서비스 설계와 구현에 필요한 실질적인 지식과 조언을 종합적으로 제공하고 있다. DDD의 핵심 개념중 하나인 도메인의 격리와 제한된 컨텍스트는 바로 마이크로서비스와 직접적으로 대응이 되고 있으며 해결 방안에 대한 아이디어또한 동일하다.
 만약 진지하게 마이크로 서비스의 도입을 검토하고 있다면 서두에서 언급한 Martin Fowler의 Microservices와 함께 DDD의 일독을 강력히 추천한다. 특히 10장에서 소개하는


  • 서비스 범위 설정 문제: 각각의 마이크로 서비스를 구성하는 범위는 어느정도가 적절할까? 단순히 크기의 문제가 아닌 어디서부터 어디까지를 묶어야 독립적으로 운영 가능한 서비스가 되느냐 의 문제이다. 이에대해서 DDD는 적절한 서비스범위에 대한 전략적인 조언을 제한된 컨텍스트Bounded context에서 제시하고 있다. 중요한것은 동일한 문제영역을 나타내는 모델이 한개 이상 존재할 수 있으며 이러한 문제영역을 올바르게 이해하는데 필요한것은 이렇게 되어야만 한다는 이상론에 집착할 것이 아니라 실제 문제역역이 어떻게 동작하고 있는가에 대해 있는 그대로를 관찰하고 이를 바탕으로 서비스를 구성하는것이 중요 한다는 점이다.


제한된 컨텍스트에 대한 예제.
위 그림과 같이 실제 문제영역에서 '고객'이나 '제품'이
서로 다른 컨텍스트에서 독립된 형태로 존재하는것은 흔히 있는 일이다.
출처 : martinfowler.com


  • 레거시 시스템과의 공존에 대한 고려: 대부분의 시스템 개발에서 마이크로서비스 아키텍처가 전면적으로 도입되는 상황이라고 하여도 기존의 (특히 단일체)시스템들과의 공존은 필연적으로 존재하기 마련이다. 이러한 상황에서 기존 시스템들과의 연계를 어떻게 해 나가야할지를 결정하는것은 상당히 중요한 문제이다. 다행이도 이미 SOA에서 많은 노하우들이 축적되어 있는 상황이므로 우리는 이에대한 조언과 사례를 쉽게 찾을 수 있다.
  • 운영오버헤드: 마이크로서비스는 엄청나게 많은양의 배포작업이 수반된다. 단순 계산만으로도 늘어나는 서비스의 수 만큼 필요하게 되며 릴리즈가 개별적으로 이루어지는 특성상 이를 별도의 운영팀에서 일괄적으로 관리하는것은 불가능에 가깝다. 따라서 배포에 수반되는 일련의 작업들을 철저하게 자동화 시키지 않으면 살인적인 작업 오버헤드에 직면하게 될 것이고, 이를 해소하기 위해 마이크로서비스 개발에 있어서 DevOps의 도입은 필수요소이다.
  • 인터페이스 불일치: 마이크로서비스에서는 서비스간의 통신에 사용되는 인터페이스에 의존하게 되는데, 각각의 서비스의 인터페이스를 변경하는것에 대한 영향범위를 파악하는것은 때에 따라서 만만치 않은 작업이 될 수 있다. 마이크로서비스 환경에서는 아주 작은 인터페이스 변경이라 할 지라도 수많은 구성요소를 수정해야 할 가능성이 있다는 것이다.
     또 한가지 마이크로서비스상에서 발생하기 쉬운 중요한 인터페이스 관련 문제는 서비스 외부로 제공하는 인터페이스가 제공자가 의도하지 않은 형태로 곧잘 사용되기도 한다는 점 이다.
     이러한 인터페이스의 불일치 문제는 전체 시스템의 인터페이스 맵을 만들어 관리해 나가는것으로 각 어느정도 해결이 가능할 것이지만 근본적으로는 각 서비스를 만들어 나가는 팀 간에 발생한느 커뮤니케이션 비용을 얼마나 효과적으로 제어 할 수 있느냐에 인터페이스의 품질이 크게 좌우된다.
  • 코드 중복: 단일한 언어나 프레임웍을 사용하여 개발된다고 하면 공유 라이브러리를 통해서 코드의 중복을 해결 할 수 있지만 여러 언어를 사용하여 개발이 진행되는경우 코드중복은 필연적으로 발생할 경우도 있다. 다언어 개발은 이러한 개발/관리상의 오버헤드가 충분히 고려된 이후에 득실을 따져서 도입하여야 한다. 한가지 희망적인 소식은 JVM이나 .net fw상에서 동작하는 여러 언어들은 각각의 환경에서 동작하는 언어 상호간에 참조에 대한 호환성을 제공하는경우가 많다. 따라서 개발효율등을 위해 다언어개발을 고려해야 한다면 이러한 라이브러리 호환성을 함께 고려함으로서 코드중복을 피해나갈 수 있을것이다.
     한편으로는 실용적인 관점에서 생각했을때 다언어 개발이 가져다주는 이점이 코드중복의 오버헤들르 상쇠시켜 주는 경우를 생각해 볼 수 있다. 이상론에 따라 코드중복을 무조건적으로 배척하기 보다는 실용적인 관점에서 손익계산을 따져볼 필요가 있다는 것이다.
  • 데이터 중복: 위의 코드중복이 다언어 개발에서 고려되어야 하는 문제라고 한다면 데이터 중복은 분산 데이터 관리 측면에서 고려 되어야 한다. 이 문제에 대해서는 사용하는 데이터 영속화의 솔루션에 따라 다양한 기술적/모델링적 접근방법이 있으므로 적당한 방법을 취하는것이 중요하다. 단, 코드의 중복과 마찬가지로 데이터의 중복이 절대적으로 해악만을 가져오는것은 아니다. 구현에 따르는 비용과 성능이 가져오는 이득을 잘 따져서 전체 시스템의 관점에서 문제에 접근하는 방식이 필요하다. 
  • 분산시스템의 복잡성과 비동기성: 마이크로서비스 아키텍처는 기본적으로 네트워크를 기반으로한 비동기 통신에 기반하여 전체 시스템이 동작하게 되므로 프로그램을 시간의 흐름에 따라 선형으로 바라보는 구조적 프로그래밍에서, 각각의 마이크로서비스들간의 관계를 중심으로 바라보는 객체지향 프로그래밍으로의  패러다임 전환이 필요하다. 다른 마이크로서비스의 문제들과 마찬가지로 DDD는 이 문제에 대한 많은 아이디어들을 제공한다. 구현적인 측면에서는 비동기성과 관련하여 최근 주목받고 있는 Actor Model(또는 Reactive 프로그래밍)을 주목할 필요가 있다. 
  • 테스트의 까다로움: 비동기로 동작하는 마이크로서비스의 특성상 개별 서비스에 대한 테스트는 만들기가 수월하지만 런타임 환경상에서 비동기 상호작용을 테스트하기는  무척이나 까다롭다. 실제로 많은 마이크로서비스 경험자들이 제품으로서 릴리스하기에 충분한가 라는 의문에 대해서 객관적인 답안을 제시하는것이 어렵다는것을 토로하고 있는데, 이 부분은 SOA진영에서 어느정도 해답이 제시되고 있으므로 이를 참고로하면 좋을것이다.

마이크로서비스 개발을 위한 개발 팀 운영에 대해서

 마지막으로 마이크로서비스 개발의 장점중에 한가지로 꼽히는 독립적인 개발 배포의 장점을 살린 개발 팀의 독립적인 운영에 대해서 살펴보면서 글을 마무리 하고자 한다.

 원래 이 부분은 Server Side Architecture Group에 올라온 조대협님의 질문에 대답해볼 요량으로 처음 손을 대기 시작했다. 그런데 막상 필자 또한 답을 찾기가 쉽지 않았다. 그러다가 마이크로서비스에 대한 자료들을 정리하며 이번 포스팅을 작성하던 도중 어느정도 생각들이 정제되었다는 확신이 들었기에 내용을 여기에 적어 보고자 한다.

 필자가 주목하는 점은 마이크로서비스 아키텍처가 지니는 특징들인 독립적인 팀 운영과 아키텍처 수립등 중앙집권적 체계를 벗어나 스스로 결정하고 책임져 나간다는 점이 스스로 결정하고 그 결정에 대해 책임진다는 자기 조직화 팀Self-Organising Teams의 주요 특징과도 일치한다는 점 이다.  즉, 마이크로서비스 아키텍처는 단일체 개발에서 보여지는 커다란 조직의 톱니바퀴로서의 역할을 강요당하는 것이 아닌 모든 멤버들이 주체가 되어 개발을 주도적으로 이끌어 나갈 수 있게 해 주는 중요한 토양을 마련해 준다는 점 이다.

 필자는 다음의 특징들을 통해 마이크로서비스가 개발팀이 자기 조직화 팀으로서 역할을 하기에 좋은 토양을 제공해 준다고 생각한다.


  • 지식노동자에게 최적화된 팀 규모에 적합한 개발 규모제공: 팀의 규모는 생산성과 효율 문제 뿐만이 아니라 팀 자체의 성격을 결정짓는 중요한 요소이다. 게다가 작은 규모는 변화에 대한 수용과 대응에 있어서 훨씬 효율적이다.


팀 인원수가 많아지면 필연적으로 무임승차자가 등장하게 된다.
이러한 무임승차자는 단순히 -1 만큼의 효과만 가져 오는것이 아니라
열심히 일하는 다른 팀원들의 사기도 저하시킨다.

  • 팀 운영에 대한 자율성: 작은 팀 규모는 운영에 있어서도 보다 많은 자유를 가져다준다. 권한없이 주인의식이 생기기를 기대하지 말라.
  • 아키텍처 선택에 대한 자율성: 아키텍처선택에 대한 권한 위임은 개발자에 대한 신뢰의 표현이기도 하다. 사용할 아키텍처를 스스로 정한다는 것은 모든 능력있는 개발자들의 소망이기 때문이다.
  • 상향식 개발: SOA실패의 원인 으로 상당수 지적되는 것이 비즈니스 주도 개발이라는 이유로 택해진 하향식개발이다. 이러한 하향식 개발은 결국 무늬만 분산형 개발이고 단일체 개발의 광범위한 계획과 일괄적인 정책 적용을 강제하게 된다.


참고자료

마이크로서비스에 대해서

레거시 시스템에서의 마이그레이션

개발팀에 대해서

데이터 중복에 대한 해결책

장애를 고려한 설계
  • Build Scalable Systems That Handle Failure Without Losing Data (MSDN Magazine) - 장해에도 굴하지 않고 데이터를 지켜내는 확장가능한 시스템을 만드는데 필요한 포괄적인 아이디어를 제공하고 있다. 분량이 만만치 않지만 충분히 읽을만한 가치가 있다.

리엑티브 프로그래밍

테스팅


2014년 8월 9일 토요일

이보시오 구글양반 내가 xx 라니...

직업적인 정체성의 문제로 고민하다가 알게된 충격적인 사실을 여기 공개한다.


맨 위부터 차례대로

프로그래머는 모두 사원으로 사원의 약 10%를 차지하고 있다
프로그래머는 두번 죽는다(으잉?)
프로그래머 파견
프로그래머는 노라고 말할 수 없다(!)
프로그래머 파견단가
junit테스트에 빠진 프로그래머는 테스트를 적는것이 좋아지게 된다

"프로그래머는 두번 죽는다"는 일본 트위터상에서 유명했던 농담임. 내용은 다음과 같다.
사춘기 딸을 둔 프로그래머가 듣는 상처받는말 
"아이고 우리 공주님. 아빠랑 같이 빌드 한번 해볼까?"
"싫어! 아빠가 썼던 변수는 같이 쓰기 싫어! 초기화 해도 싫어!"
빌어먹을... 저는 그저 웃을 수 밖에 없었습니다.

대한민국 개발자들에게 무슨일이 있었던 것일까...